生成式图像与视频模型
把同意内建在流程里的视觉模型。
第二个研究支柱:生成式图像与视频模型,用于可控合成、参考导向的创作、本地化、粤语语音、配音、唇形同步,以及取得同意的虚拟主持。
生成式图像与视频模型
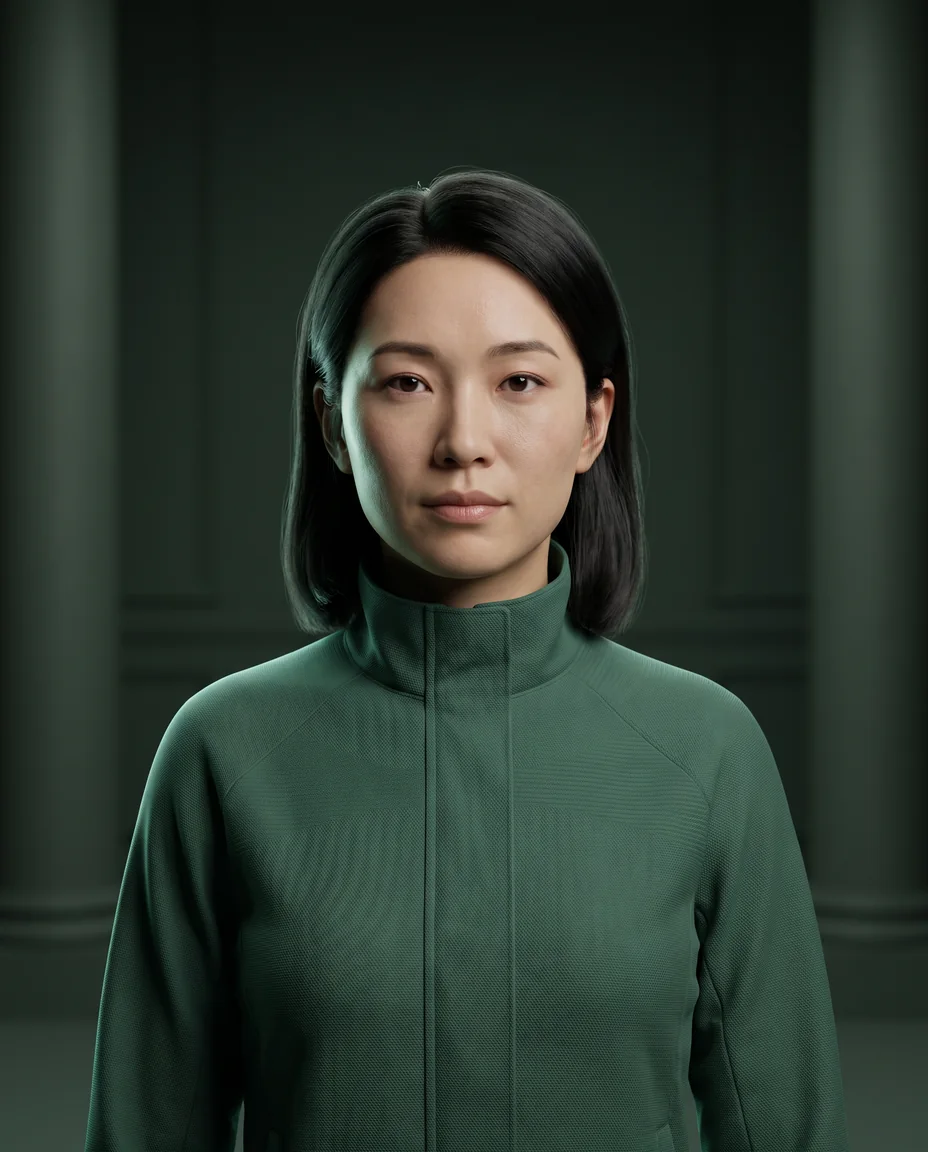
WB 视觉模型 / 预览
WB 视觉模型 / 预览
虚构人工智能主持 · 已开启披露
视觉生成与安全流程
- 01 界定视觉意图提示、参考与权利 就绪
- 02 核实资料权利图像、身份与语音同意 未开放
- 03 生成图像、视频、语音与本地化 未开放
- 04 真人复核披露与质量关卡 未开放
- 05 发布水印与来源纪录 未开放
此为确定性的前端演示。浏览器不会进行任何生成,亦不会呼叫任何模型。
图像合成视频生成照护教育员工培训产品演示本地化与配音
此处所示的主持是人工智能生成的虚构人物。他不是真人、并非员工、并非临床人员,亦不是持牌顾问,并且不会提供任何建议。
流程
九个步骤,未到第九步不会发布。
01
界定视觉意图
在开始制作之前,先记录用途、受众、负责人与所需输出。
02
核实素材
核查提示、文稿、事实陈述与来源权利。
03
取得同意
只使用已具备现行、按用途发出的同意的参考图像、肖像与语音。
04
记录本次运行
模型版本、供应商、提示、参考、种子与参数,与输出一起保存。
05
隔离生成
在一项设有时间、成本与内容上限的工作之内进行。
06
扫描输出
在任何人看到之前,检查身份、披露、安全与政策问题。
07
披露
加上清晰可见的人工智能披露,以及支持的来源资料或水印。
08
具名真人复核
由具名复核人在发布前批准该文件的确切杂凑值。
09
保留控制
发布之后,撤回、删除与事故应变机制仍然有效。
用途
视觉模型应用在哪里。
- 图像合成
- 视频生成
- 照护教育
- 员工培训
- 产品演示
- 本地化与配音
评估
测量什么。
- 01 提示忠实度:输出是否就是所要求的内容。
- 02 视觉质量,由真人判断,而不是单靠分数。
- 03 身份相似度,而且只在获授权的范围之内。
- 04 粤语语音对齐,并以真实粤语素材核查。
- 05 披露的可见程度与来源纪录的保留情况。
- 06 真人复核完成率:具名复核人实际签核的比例,以及他们拒绝了什么。
角色与权利是两个独立问题
主持只能以已就特定用途取得同意的肖像来建立,而且同意可以在事后撤回。
每项已发布的素材都会带有清晰可见的人工智能披露。合成人物永远不会被说成是真实的员工。
客户无法出示权利的参考,一律不会用来生成。